
深度分层无监督意图建模:无需训练数据即可获取价值
Automation Cloud 上的 IXP 中的深度分层无监督意图建模,可在没有训练数据的情况下从通信中提取价值。
企业生存与发展依赖于沟通 - 客户有需要时可以寻求帮助,同事也可以通过沟通来完成工作。每一条消息都很重要。Communications Mining™ 的使命是释放这些消息中的价值,并帮助企业中的每个团队高效、大规模地交付更好的产品和服务。
为了实现这一目标,我们持续研究和开发核心的机器学习和自然语言理解技术。Communications Mining 的机器学习模型使用预训练、无监督学习、半监督学习和主动学习,可让用户以最少的时间和投资提供最先进的准确性。
在这篇研究文章中,我们探索了一种新的无监督方法,用于从通信数据集中自动识别主题和意图及其分类结构。 这是为了提高我们提供的见解的质量以及获取这些见解的速度。
摘要
主题模型是一类方法,用于发现“文档”集合中出现的“主题”。重要的是,主题模型无需收集任何已批注的训练数据即可工作。它们会自动识别数据集中的主题以及每个文档中出现的主题。
一封假设的“交易失败”电子邮件,以及我们希望自动推断的层次结构主题类型
在这篇文章中:
- 我们解释了传统的主题模型,并讨论了它们的一些缺点,例如,必须提前知道主题的数量,不捕获主题之间的关系等。
- 我们会将主题组织为根据数据集的主题结构自动推断出的层次结构。该层次结构将语义相关的主题分组在一起。
- 通过将基于变换器的嵌入合并到模型中,我们实现了更加连贯的主题层次结构。
背景
主题模型假定数据集(文档集合)包含一组主题。 主题指定每个词在文档中出现的可能性。 数据集中的每个文档都是由多个主题混合生成的。 通常,经常一起出现的词组在给定主题中出现的概率较高。
例如,假设我们有一个由以下文档组成的数据集:
- 文档 1 “”
- 文档 2 :“猫是食舍动物,长有触须和可缩回的利子”
- 文档 3 :“众所周知,大型猫科动物会攻击人类”
- 文档 4 :“被猫尖利的爪子划破后,有些猫会感到恐惧”
- 文档 5 :“相比于带其他家教,家教可能更喜欢和猫在一起”
基于这些文档训练的主题模型可以学习以下主题和文档主题分配:
| 主题 1 | 主题 2 |
|---|---|
| 搜狗 | 猫 |
| 已家化 | 爪子 |
| 狼 | 胡须 |
| ... | ... |
示例主题,其中包含按最高概率排序的词。
| 主题 1 | 主题 2 | |
|---|---|---|
| 文档 1 | 100% | 0% |
| 文档 2 | 0% | 100% |
| 文档 3 | 50% | 50% |
| 文档 4 | 33% | 67% |
| 文档 5 | 67% | 33% |
文档-主题分配示例。
通过查看每个主题最有可能出现的词语以及每个文档所属的主题,可以大致了解数据集中的文本是什么,以及哪些文档彼此相似。
嵌入式主题模型
此规范主题模型称为潜在狄利克雷分配 (LDA) 。这是一个生成式模型,使用(近似)最大可能性估计进行训练。LDA 假定:
- 有K 个主题,每个主题都指定词汇表(数据集中的词集)上的分布。
- 每个文档(单词集合)都有一个主题分布。
- 文档中的每个单词都是根据文档在主题上的分布和主题在词汇表上的分布,从一个主题生成的。
大多数新式主题模型都是基于 LDA 构建的;最初,我们专注于嵌入式主题模型 (ETM) 。ETM 使用嵌入来表示单词和主题。在传统主题建模中,每个主题都是词汇表的完整分布。然而,在 ETM 中,每个主题都是嵌入空间中的一个向量。对于每个主题,ETM 使用主题嵌入形成词汇表的分布。
训练和推理
文档的生成流程如下:
-
从先决分布中对潜在表示z进行采样: z ``N( 0 , I ) 。
-
计算主题比例theta =softmax( z )。
-
对于文档中的每个词w :
- 潜在主题分配示例
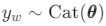 2. 对词进行抽样
其中U ins v E 是单词嵌入矩阵,tyw 林 RE 是主题 yw 的嵌入;这些是模型参数。V表示词汇表中的字数, E表示嵌入大小。
包含单词v 1, v 2,…, vw的文档的对数可能性为:
其中:
遗憾的是,之前提到的积分问题很难解。因此,直接最大化对数可能性并不容易。相反,它会使用变分推理来近似最大化。为此,将使用“推理”分布 qtheta ( z ∣ x )(参数为path ),根据Jensen 不等式形成对数可能性的下限,其中x = x1 ,…,xW :
现在,可以通过所谓的“重新参数化技巧” ,使用梯度的蒙特卡罗近似值来最大化此下限。
高斯分布用于推理分布,其均值和方差是神经网络的输出,该神经网络将文档的词袋表示作为输入。
借助上一个训练目标,推理分布可以学习近似真实但难以处理的后缀,即*qθ*(**z**∣**x**)≃*p*(**z**∣**x**) 。这意味着,训练模型后,我们可以使用推理分布来查找文档分配给的主题。
取推理分布的均值并应用 Softmax 函数(根据上一个生成过程的步骤 2),将为给定文档提供大致的后备主题比例。
真实示例
我们在20 个新闻组数据集上训练 ETM,该数据集包含论坛中针对 20 个层次主题的评论,分类如下:
- 计算: comp.图形,comp.os.ms-windows.misc,comp.sys.ibm.pc.硬件、comp.sys.mac.硬件、comp.windows.x
- 娱乐: rec.autos、rec.Motorcycles、rec.sport.baseball、Rec.sport. Hockey
- 科学: sci.crypt、sci.Elasticsearch、sci.med、sci.space
- 时事通讯: chat.politics.misc,chat.politics.guns,look.politics.mideast
- 宗教: chat.re教.misc,atheimalt.soc.re Legion.chrysian
- 其他: misc.forsale
在 Communications Mining,我们只处理通信数据,这是出了名的隐私。出于可重复性考虑,且由于它是机器学习研究文献中最常用的主题建模数据集,我们在此处使用包含 20 个新闻组的数据集。这被视为主题建模的“你好世界” 。
我们使用 20 个主题(即K = 20),因为对于此数据集,我们已经知道其中有多少个主题(但通常情况下不会如此)。我们使用Gmail来初始化嵌入矩阵U 。
下图显示了为每个主题学习的前 10 个单词,以及将每个主题作为最有可能出现的文档的数量:
ETM 学到的每个主题的最有可能出现的词
学习到的热门单词与数据集中的真实主题大致匹配,例如主题 2 =****************************************************************************************,主题 13 = sci.space,等对于每个文档,我们还可以查看主题分配概率;后续部分将显示一些示例。某些文档很有可能属于单个主题,而其他文档则是多个主题的混合。
示例 1
这看起来很可气,但是虽然我找到了可以编辑 gif 文件的 tgif 等工具,以及用于与 gif 格式转换的各种工具,但我一直无法找到仅打开窗口并显示 gif 文件的程序在其中。我已查看各种常见问题文件,也无济于事。是否有人隐藏在某个存档中?简洁;只是“展示图片”?
或者,如果我可以找到 gif 的规范,我想自己编写它不会太难,但我不知道从哪里开始寻找规范。(实际上,我确实有一个想法 - 关于这个新闻组。;-)获取,xv,版本 3.0。它可以读取/显示/操作许多不同的格式。
示例 2
您提及的守门员是克林特·马拉丘克。 那时他正在为佩刀队效力。 在此之前,他的球队是华盛顿首都队。 虽然他确实恢复了并继续比赛,但我不知道他目前的下落。
示例 3
大家好,在网络世界里,我们有一个旧版 Mac(SE 和 Pluses)的实验室。 我们没有足够的资金购买所有新计算机,因此正在考虑为旧 Mac 购买一些超级驱动器,以便拥有高密度磁盘的用户也可以使用我们的设备。 我想知道人们对这种升级有什么经历(好的或坏的)。 默里
这些结果表明,即使在事先不了解数据集的情况下,也可以快速轻松地了解数据集,识别每个文档所属的主题并将相似的文档分组。 如果我们还想收集带注释的数据来训练监督任务,则主题模型输出使我们能够从更明智的角度开始注释。
树结构主题模型
尽管上一节中所述的主题模型非常有用,但它们具有某些限制:
- 必须提前指定主题数量。 一般来说,我们不知道正确的数字应该是什么。
- 尽管可以训练具有不同主题数量的多个模型并选择最佳模型,但这样做的成本很高。
- 即使我们确实知道正确的主题数量,学习到的主题也可能与正确的主题不符,例如 图 1 中的主题 16 似乎并不与 20 个新闻组数据集中的任何真实主题相对应。
- 模型不会捕获主题之间的相互关系。 例如,图 1 中有多个有关计算的主题,但模型无法学习这些主题相关的概念。
在现实中,通常的情况是,主题的数量事先未知,并且主题在某种程度上彼此相关。解决这些问题的一种方法是将每个主题表示为树中的一个节点。这使我们能够对主题之间的关系进行建模;相关主题可以位于树的同一部分。
这将提供更容易解释的输出。此外,如果模型可以从数据中了解应有的主题数量以及它们之间的关系,则我们无需提前知道这些信息。
为实现此目的,我们使用基于树结构神经主题模型 (TSNTM) 的模型。生成式流程的工作原理是选择一条从树的根到叶子的路径,然后沿该路径选择一个节点。使用不粘滞过程对树路径的概率进行建模,该过程使用双重递归神经网络进行参数化。
中断流程
破坏粘子过程可用于对树的路径进行概率建模。直观地说,这涉及重复断开最初长度为 1 的棒。对应于树中节点的棒所占的比例表示沿该路径的概率。
破坏粘性流程,所占比例为绿色
例如,考虑图 2 中的树,其中每层有 2 个层和 2 个子元素。 在根节点,连接长度为 1。 然后将其分成长度分别为 0.7 和 0.3 的两部分。 然后进一步分解每个部分,直到到达树的叶子。 因为我们可以不断地折断棒子,所以树的宽度和深度可以是任意的。
双重递归神经网络
与 ETM 中一样,TSNTM 的生成流程首先从先天分布中对潜在表示z进行采样:
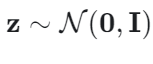
双重递归神经网络 (DRNN)用于确定违规行为的比例。随机初始化根节点h 1的隐藏状态后,对于每个主题k,隐藏状态h k 由下式给出:
其中hpar (k) 是父节点的隐藏状态, h k-1 是紧接其前的同级节点的隐藏状态(同级节点根据其初始索引排序)。
分配给主题 k,vk 的剩余棒比例由下式给出:
然后,节点 k,pik 处的概率由下式给出
其中j ii {1,…, k -1} 是节点k的前一个同级节点。这些是图 2 中绿色值。每个叶节点的值是该路径的概率(到每个叶节点只有一条路径)。
已有树路径的概率后,我们还需要每条路径中节点的概率。这些数据是使用另一个破坏粘滞的流程计算得出的。在树的每个级别,隐藏状态g l 由下式给出:
这意味着处于树同一级别的所有节点都具有相同的g l 值。
分配给级别 l,nl 的剩余棒的比例由下式给出:
级别 l,thetal 上的概率由下式给出:
根据经验,我们有时发现树中子节点最可能出现的词语在语义上与其父节点的词语无关。 为解决此问题,在等式 2 中,我们应用一个温度来软化 S 形函数:
在我们的实验中,我们设置 False = 0.1。 这使得当子节点具有非零概率质量时,其父节点更可能也具有非零概率质量(减少子节点与其父节点无关的可能性)。
训练和推理
训练目标与等式 1 中的相同;唯一的变化是 p(xw=vw|z) 的指定方式。 现在由下式给出:
更新树结构
到目前为止,树结构已修复。但是,我们希望根据数据来了解这一点。将树的确切结构指定为超参数比简单地指定多个主题要困难得多(就像我们为平面主题模型所做的那样)。如果我们事先知道树的一般结构,则可能不需要对主题进行建模。
因此,树结构主题模型的实际应用程序需要能够从数据中学习结构。为此,需要使用两个启发式规则在树中添加和删除节点。首先,使用训练数据的随机子集估计每个节点的总概率质量。在节点k ,此估计值为:
其中d ={1,…, D } 为随机选择的文档子集建立索引,而 Nd 会给文档d中的字数。根据这些估计值,在每I次迭代后:
- 如果 pk 高于阈值,则会在节点k下添加一个子节点,以优化主题。
- 如果累积和
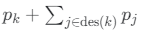 小于阈值,则删除节点k及其后代。
20 个新闻组的结果
我们在用于训练上述 ETM 的相同 20 个新闻组数据集上运行 TSNTM。我们将树初始化为 2 个层,每层有 3 个子节点。下图显示了最终的树结构、为每个主题学到的前 10 个单词,以及最有可能将每个主题作为主题的文档数:
TSNTM 学习的每个主题的最有可能出现的词
与平面主题模型相比,树结构方法具有明显的优势。树是从数据中自动学习的,相似的主题会被分组到树的不同部分。
更高级别的主题位于树顶部(例如出现在大量文档中的信息不足的单词位于根目录中),更精细/更具体的主题位于叶层次结构中。与图 1 中的平面模型输出相比,这可以获得更丰富的信息且更易于解释的结果。
以下部分显示了示例文档和 TSNTM 学习的相关主题分配概率:
示例 1
我们的实验室刚刚收到一台 AppleOne 彩色扫描仪。但是,在LaserWriter IIg 上打印扫描照片时,我在获得合理的扫描输出时遇到了问题。我已尝试以更高的分辨率进行扫描,屏幕上的显示效果非常好。但是,打印版很难看!
这是否是由于打印机的分辨率功能所致?或者是否有一些技巧可以提高质量?或者,我们是否应该使用某些工具(如 PowerPoint)来“美化”图像?如有任何建议,我将非常感谢。预先致以感谢, -Kris
示例 2
战局结束 - 密钥马器队通过加时审阅以 6-5 逆转灰树决策者节,横取系列产品。布拉德 梅 (拉方丹在场上倒地时柱传) 送出一记精彩的绝杀。富尔因右任务退场,拉方丹也受了重击;不过,Sabers 队将获得一周的休息时间,因此损伤应该不是问题。
满地可 3-2 击倒了倒数第二个加拿大人,他们的系列文章似乎进入了第 7 场。 哈布斯队控制了前两个一节,但很遗憾,他们在 40 分钟后只将战成 2-2 平。但是,凭借布隆内在第 3 场早早打入的目标,最终锁定胜局。
凭借Ray Ferraro 的入主,岛人队以 4-3 赢得了该系列第 3 场加时战;卡普斯队在第二节以 3-0 领先后崩溃了。群岛目前取得了 28 胜 7 负的历史性附加值。
示例 3
请告诉我在哪里可以以低于 20 美元的价格购买 Wergo 音乐公司的 CD。
明确属于特定主题的文档(例如第一个文档)在叶节点的概率较高,而那些不明确属于任何已学主题的文档(例如第三个主题)在根节点的概率较高。
量化评估
众所周知,主题模型很难量化评估。但是,用于衡量主题一致性的最常用指标是归一化逐点互信息 (NAPI) 。采取每个主题的前 M 个单词,如果每对单词 wi 和 wj 拥有与其边际概率 P(wi) 和 P(wj) 相比的更高联合概率 P(wi,wj),则 NPMMI 将为高值:
概率是使用经验计数估计的。
| NPMI | |
|---|---|
| ETM | 0.193 |
| TSNTM | 0.227 |
这些结果支持定性结果,即 TSNTM 是一个比 ETM 更具连贯性的模型。
合并变换器
尽管 TSNTM 会生成直观且易于解释的结果,但学习的模型仍然存在漏洞。例如,在图 3 中,与策略和空间相关的主题已分组到同一父节点下。这可能并非没有理由,但其父节点与教义相关,这可以说是不连贯的。
另一个更微妙的示例是,主题 1.3 将与硬件和软件相关的计算主题分组;两者也许应该分开。
我们假设出现这些问题是因为到目前为止训练的模型都是基于(非上下文)GloVe 嵌入。 这可能会难以消除在不同上下文中具有不同含义的单词的歧义。 在过去的几年中,基于 Transformer 的模型在学习文本的信息性上下文表示方面取得了最先进的性能。 我们希望将嵌入的 Transformer 合并到 TSNTM 中。
将嵌入的转换器添加到 TSNTM 中
我们遵循组合主题模型 (CTM)的方法。现在,我们不仅将词包表示作为推理模型的输入,还将词包表示与 Transformer 模型最终层状态的均值连接在一起。尽管这是一个简单的修改,但应该允许推理模型学习更好的后缀近似值。
对于 Transformer 模型,我们使用Sentence-BERT (SBERT)的all-mpnet-base-v2变体,因为它在许多句子级任务上始终取得高分。
我们训练一个模型,该模型在其他方面与上一节中的 TSNTM 相同,不同之处在于将 SBERT 嵌入添加到推理模型中。同样,下图显示了为每个主题学习的前 10 个单词,以及将每个主题作为最有可能出现的文档的数量:
SBERT+TSNTM 学习的每个主题的最有可能出现的单词
具有 SBERT 嵌入的 TSNTM 似乎解决了仅 Gmail 模型的一些不连贯问题。投资回报率、政策和加密主题现在分组在同一父主题下。但与仅 Gmail 模型不同,此父主题现在是一个更通用的主题,其热门关键词与人们表达意见相关。
计算机硬件和软件主题现已拆分,空间在树中属于它自己的部分。NCRM 还认为,使用 SBERT 嵌入的模型更具连贯性:
| NPMI | |
|---|---|
| ETM | 0.193 |
| TSNTM(仅限 GloVe) | 0.227 |
| TSNTM (GloVe + SBERT) | 0.234 |
摘要
我们已经证明,主题模型是一种很好的方法,可以让您深入了解数据集,而无需进行任何注释。
- “扁平”主题模型是最常用的模型,但也存在一些缺陷(例如 输出不易解释,需要提前知道主题的数量)。
- 这些缺陷可以通过使用树结构模型来解决,该模型将相关主题分组在一起,并自动从数据中学习主题结构。
- 使用 Transformer 嵌入可以进一步改善建模结果。